Eure Projekte bekommen ein Nervensystem, gebaut wie ein lebendes.
Ein Sprachmodell vergisst alles, sobald ein Gespräch endet. Nervensysteme lösen das in Schichten, von Sinnen, die nie abschalten, bis zu einem Gedächtnis, das den richtigen Moment findet, und AUVY ist aus denselben Schichten gebaut, mit einem Menschen, der oben entscheidet. Anders als ein Gehirn behält es jedes Wort.
Ein ganzes Nervensystem
Erst das ganze System, im echten Projekt.
1991 plädierte der Robotiker Rodney Brooks dafür, vollständige Systeme zu bauen, die von Anfang an in der echten Welt handeln, in Schichten, die jede für sich funktionieren und mit der Zeit fähiger werden. Nervensysteme sind so gewachsen, und AUVY ist so gebaut.
- SinneMails und geänderte Dateien kommen hier zuerst an, und jedes Stück wird gelesen, datiert und seinem Projekt zugeordnet, sobald es eintrifft.
- GedächtnisAlles, was das Projekt bekommen hat, bleibt wörtlich und mit Quelle erhalten, und eine Frage findet es über ein Datum, eine Person oder das, was gemeint war.
- Vorbereitete SchritteÄndert sich etwas, ermittelt AUVY, was es betrifft, und entwirft den nächsten Schritt, etwa eine Antwort an den Kunden oder einen neuen Termin im Plan.
- Ein Mensch entscheidetJeder Entwurf hält hier an, bis jemand ihn annimmt, ändert oder verwirft, und erst dann geht er raus.
Wie es findet
Was das Gehirn tut, um eine Erinnerung zu finden, und was AUVY davon übernimmt.
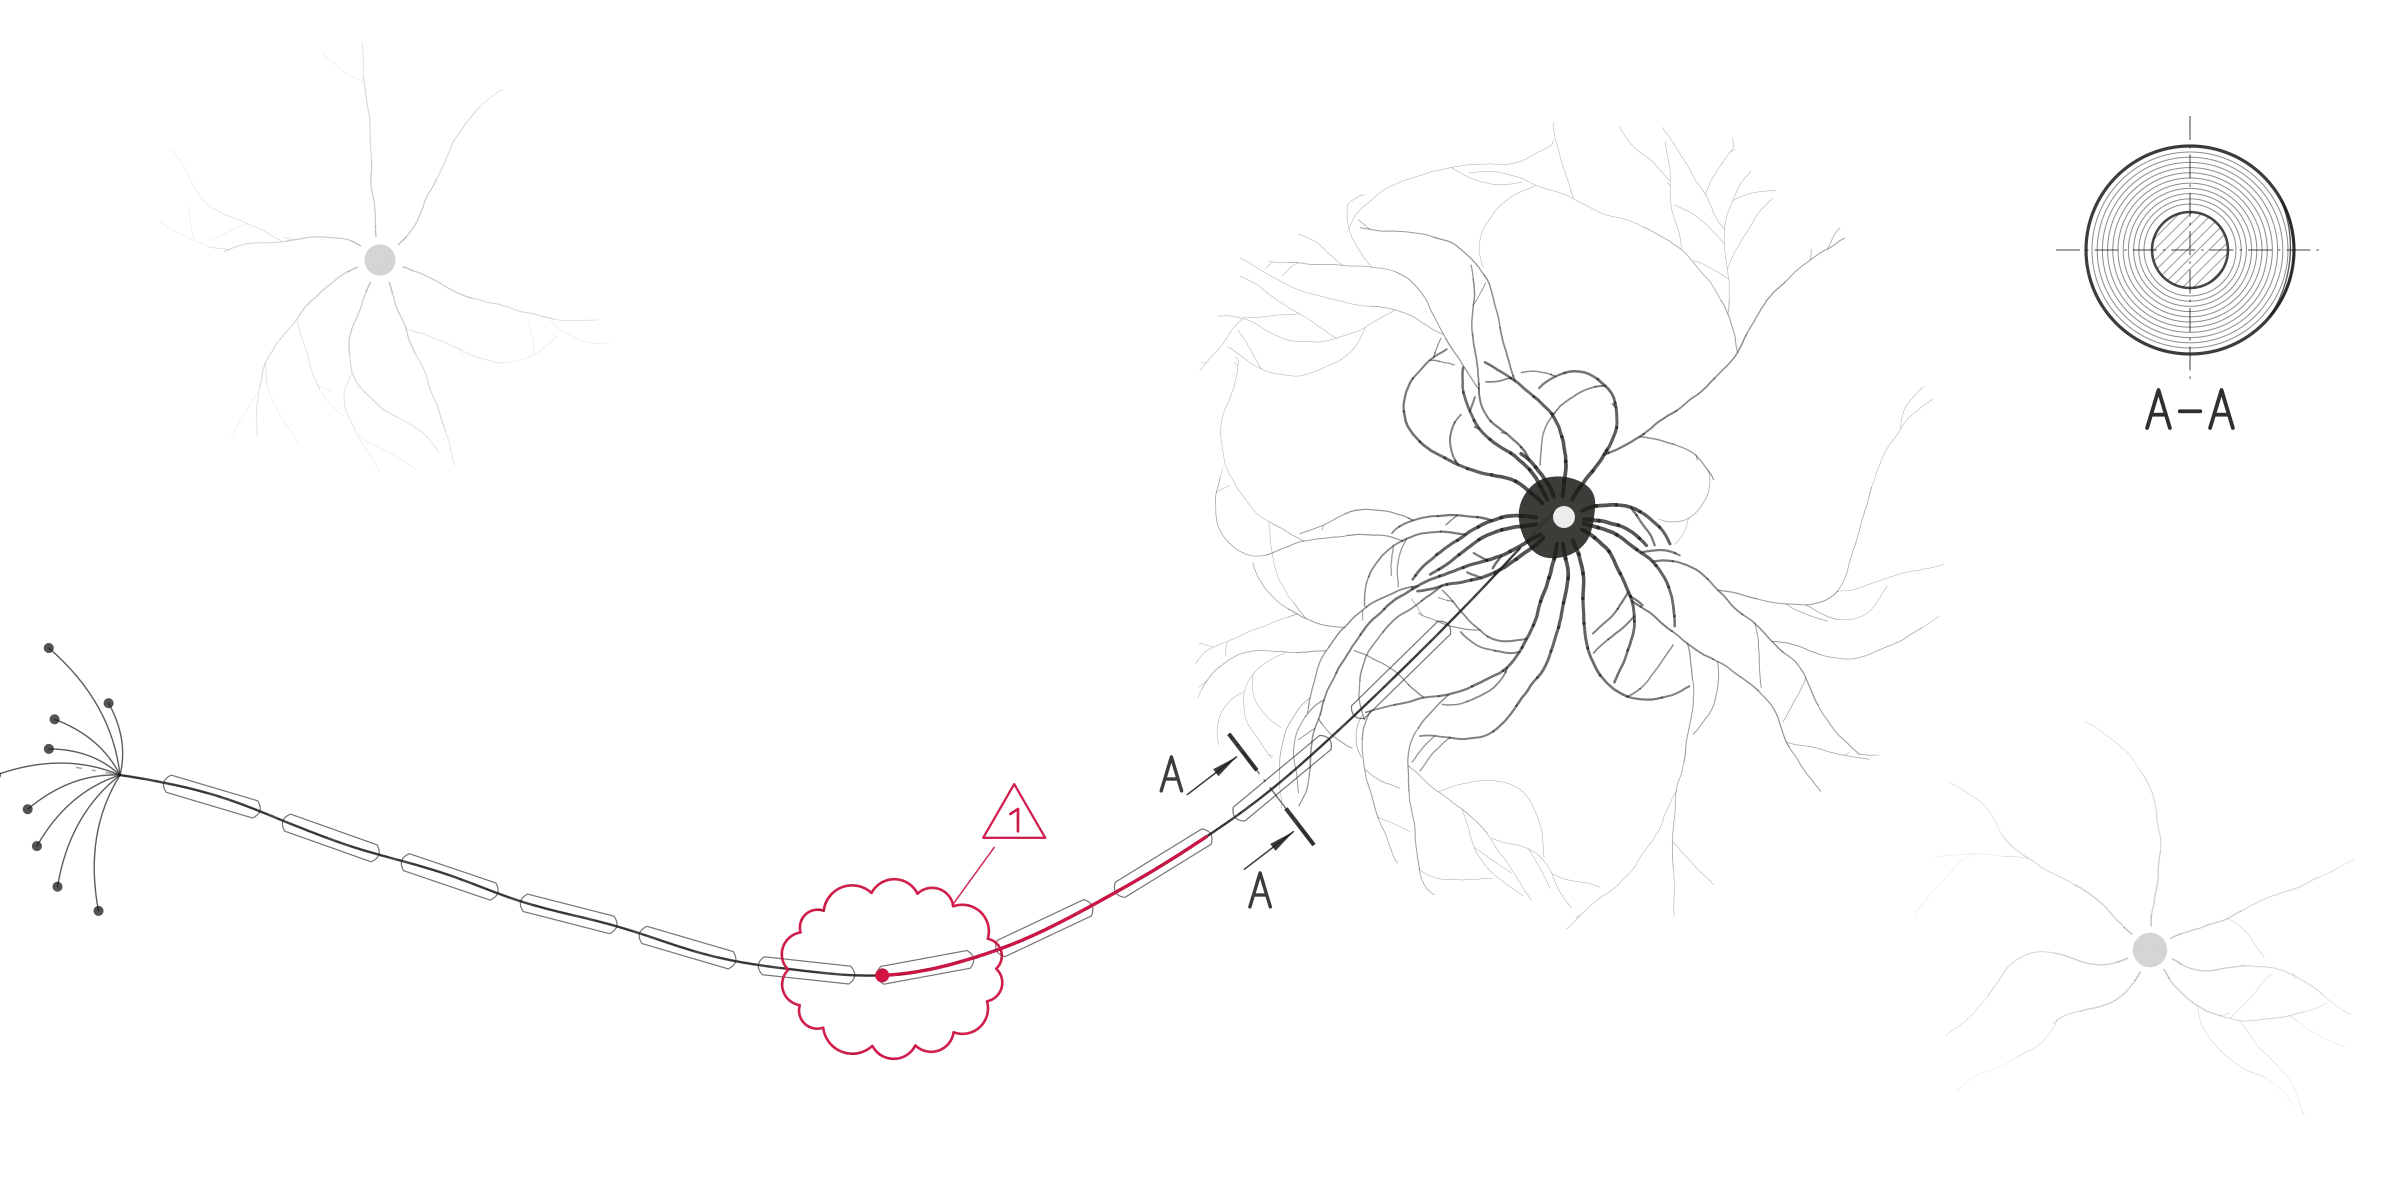
Euer Gehirn lässt die meisten Details fallen, findet aber das eine, was ihr braucht, über ein Datum, einen Ort, einen Namen oder einen halben Satz. Jeder Ring ist ein Vorgang, den die Gedächtnisforschung beschreibt, und was AUVY daraus baut, wobei AUVY die Details behält, die das Gehirn verlieren würde.
- Ein Fakt, eine Spur
Im Gehirn: Zwei ähnliche Besprechungen bleiben zwei Erinnerungen. Sie verschwimmen nicht zu einer.
In AUVY: Mails und Dateien werden in Stücke mit je einem Fakt geteilt, damit eine Suche genau die Stelle trifft, die ihn enthält.
- Wann und wo
Im Gehirn: Oft findet man eine Erinnerung über den Tag oder den Raum, in dem es passiert ist.
In AUVY: Jede Stelle kennt ihr Datum und ihren Ordner, deshalb sucht AUVY bei einer Frage nach letzter Woche oder einem Ordner zuerst dort.
- Personen und Beziehungen
Im Gehirn: Man weiß, wer mit wem arbeitet, ohne sich zu erinnern, woher.
In AUVY: AUVY baut aus dem Gelesenen eine Karte von Personen, Firmen und Besprechungen, jede Verbindung mit dem Satz, der sie nennt, und eine Frage zu jemandem folgt diesen Verbindungen.
- Vom Bruchstück zum Ganzen
Im Gehirn: Ein Geruch oder ein halber Satz holt die ganze Szene zurück.
In AUVY: Findet eine Suche eine Stelle, liest AUVY auch den Abschnitt oder Thread drumherum, damit hinter der Antwort das ganze Gespräch steht.
- Über Nacht einordnen
Im Gehirn: Im Schlaf geht das Gehirn den Tag noch einmal durch und ordnet ein, was wichtig war.
In AUVY: Im Hintergrund macht AUVY aus neuen Mails und Besprechungsnotizen kurze Fakten und Zusammenfassungen, die eine Suche findet, jede mit Verweis auf das Original.
- Der neuere Fakt zuerst
Im Gehirn: Erfährt man, dass sich etwas geändert hat, tritt die neue Fassung an die Stelle der alten.
In AUVY: Ändert sich ein Termin oder ein Preis, kommt die neueste Aussage zuerst und die alte bleibt erhalten, markiert durch die rote Wolke in der Zeichnung.
- Was zuerst einfällt
Im Gehirn: Was man oft braucht, fällt einem zuerst ein, und was man nie braucht, verblasst.
In AUVY: Stellen, die niemand nutzt, rangieren etwas tiefer, wenn zwei sonst gleich gut sind, aber gelöscht wird keine.
- Wissen, was man nicht weiß
Im Gehirn: Man merkt, wenn man etwas nicht weiß, und sagt es.
In AUVY: Steht die Antwort nicht in den Quellen, sagt AUVY, dass es nichts gefunden hat, und markiert jeden Satz, den es nicht mit einer Quelle belegen kann.
- Jenseits des Gedächtnisses
Im Gehirn: Das Gedächtnis ist eines von mehreren Dingen, mit denen das Gehirn gut handelt.
In AUVY: Denselben Weg wollen wir bei Aufmerksamkeit, Vorhersage und Planung gehen.
Ergebnisse
Vier öffentliche Benchmarks, kein fremdes Modell in der Suche.
Sie prüfen, ob in einem langen Verlauf die richtige Stelle gefunden wird und ob die Antwort daraus stimmt. Die Benchmarks nutzen Chatverläufe, wo AUVY Projektmails und Dateien liest, aber die Aufgabe ist dieselbe.
| Benchmark | Was er testet | Anzahl | AUVY | Andere Systeme |
|---|---|---|---|---|
| Finden | ||||
| LongMemEval-S | Das Gespräch finden, das die Antwort enthält, unter etwa 50 pro Frage | 500 | 99,4Höchster Wert |
|
| LoCoMo | Die Sitzung finden, die die Antwort enthält, in zehn Gesprächen über Monate | 1.540 | 94,9 | – |
| Antworten | ||||
| MemConflict | Antworten, wenn gespeicherte Fakten sich widersprechen | 3.750 | 70,4Höchster Wert |
|
| LongMemEval-S | Aus rund 115.000 Tokens Chatverlauf antworten | 500 | 91,8 |
|
| LoCoMo | Fragen zu denselben zehn Gesprächen beantworten | 1.540 | 91,8 |
|
| BEAM 1M | Zehn Gedächtnisfähigkeiten über Gespräche von rund einer Million Tokens | 700 | 62,4 |
|
Finden: die richtige Quelle unter den ersten fünf Treffern. Antworten: Anteil richtig, bewertet so, wie die anderen Systeme berichten: LongMemEval mit seinen eigenen Judge-Prompts, LoCoMo mit dem veröffentlichten Prompt von Mem0, MemConflict als Mittel über die drei Konfliktarten. BEAM: Nugget-Score von 0 bis 100, Judge-Prompt von Mem0; alles andere in Prozent. Andere Systeme so, wie sie veröffentlichen, jeweils mit eigenem Antwortmodell; ein Strich, wo niemand dasselbe Maß veröffentlicht.
Offene Probleme
Woran wir als Nächstes arbeiten.
- Jede Quelle, nicht nur eine
- Die Suche findet fast immer eine Quelle, die eine Antwort braucht, aber nicht immer jede. Am meisten verlieren Fragen, die mehrere Gespräche verbinden. Hier setzt „Über Nacht einordnen“ an.
- Zeit und Veränderung
- Fragen zum neueren von zwei Fakten, zu Zeit und zur Reihenfolge von Ereignissen schneiden am schwächsten ab, ebenso Fakten, die sich nicht hätten ändern dürfen. Hier setzt „Der neuere Fakt zuerst“ an.
Methode
Wie die Zahlen entstanden sind.
- Was lief
- Dokumentenspeicher und Suche von AUVY liefen auf einem eigenen Benchmark-Stack ohne Kundendaten, mit eigenem Workspace und Index für jeden Benchmark. Jeder Benchmark und jedes Modell lief einmal vollständig, und jede Frage zählt, keine wurde weggelassen oder wiederholt.
- Suche
- Hybride Stichwort- und Vektorsuche mit dem Mischen und Reranking wie oben beschrieben, ohne externes Reranking-Modell in einem der gezeigten Läufe. BEAM lief mit einer einfacheren Konfiguration derselben Suche.
- Leser und Judges
- GPT-6 Luna liest und bewertet LongMemEval, LoCoMo und MemConflict, der Leser mit hohem Reasoning-Aufwand, und GPT-5.6 Luna macht bei BEAM beides. LongMemEval und MemConflict nutzen ihre eigenen Judge-Prompts, LoCoMo und BEAM den Prompt, den Mem0 veröffentlicht, so wie die anderen Systeme berichten. Die Anweisungen an den Leser nennen keine Benchmark-Frage und keine Antwort.
- Veröffentlichte Zahlen
- Aus den Berichten der Anbieter. Wir haben sie nicht nachgerechnet. Unser Benchmark-Harness ist nicht öffentlich.
Benchmarks und veröffentlichte ErgebnisseLongMemEval ↗LoCoMo ↗BEAM ↗MemConflict ↗Mem0 research ↗gbrain-evals ↗